
 AI通识教育

 人工智能专业建设
 大数据专业建设
 数智人才综合解决方案
 产业实践
 合作高校
 用户声音
 协同育人


 关于我们
 专家团队
 服务体系
 应用场景
 生态合作
 新闻资讯
 400-608-2558400-608-2558
腾讯研究院的调研显示:78%的企业已经在用AI,但80%尚未见到明显的利润改善。
问题不在算法,也不在算力,在数据。
通用大模型可以回答通识问题,但要让它看懂一家企业的业务、一套设备的工况、一份合同的风险,靠的是这个行业自己的高质量数据集。行业里有句话:“模型决定下限,数据决定上限。”
而这,恰恰是当下最稀缺的东西。
2022年12月,"数据二十条"发布,数据产权、流通交易、收益分配、安全治理的制度框架正式确立;2023年10月,国家数据局挂牌;2024年12月,"高质量数据集"首次被写进国家产业政策;2025年2月,27个部委联合启动高质量数据集建设;2025年8月,国务院《关于深入实施"人工智能+"行动的意见》明确要强化"算力、算法和数据供给”。
到2025年底,全国已建成高质量数据集超过10万个,总规模890PB,首批30项央企高质量数据集落地。2026年,国家数据局进一步印发《关于推进行业高质量数据集建设行动的实施方案》,提出"场景牵引数据、数据驱动模型、模型赋能应用、应用创造价值"的数据飞轮,把工业制造、金融服务、交通物流、教育等十大行业列为攻坚方向。
数字听起来不小,但放到千行百业的需求面前,只是刚刚开始。
一个判断随之清晰:AI时代最缺的,不是会调模型的人,而是能把一堆原始数据,变成模型真正可用的高质量数据集的人。——这恰好是大数据管理与应用专业的机会。
过去几年,AI竞争的焦点是模型。谁参数多、谁效果好,谁就领先。
但2025年之后,格局变了。开源模型的能力被迅速拉平,一张显卡就能跑起来的开源大模型比比皆是。企业之间的差距,不再取决于"用哪个模型",而取决于"喂什么数据"。
什么样才算高质量数据集?四个硬指标:权威性(来源可靠、经过审核)、标准化(格式、元数据、标注体系统一)、高质量(完整性、准确性、一致性经得起校验)、可应用(面向明确场景,能直接支撑训练与推理)。
这四个指标,恰恰是"技术活"和"管理活"的混合体——你得懂技术,才能把采集、清洗、治理、向量化做扎实;你得懂管理,才能把数据标准、质量规则、元数据、血缘、安全合规立起来;你还得懂业务,才知道这份数据在业务上"对不对"。
这正是"技管双强"最难的地方,也恰恰是它最值钱的地方。
人才端的信号已经很明确。我国大数据相关岗位人才缺口约230万,年增长率15%,数据分析与治理领域的供需比达到1:4.3。而在需求结构里,数据治理型人才占约25%,是公认"缺口最大、补得最慢"的一类。
一句话:大数据管理与应用专业过去被诟病的"两边都不够深",在AI时代反而成了"两边都够用"的稀缺优势。
定位不清,课程一定发散。
过去谈大数据管理与应用专业,常用一句话概括:“技管双强”——既懂技术又懂管理。方向没错,但落点太虚。什么叫"强"?强到什么程度?和"数据科学与大数据技术"到底差在哪?
在AI时代,这个定位可以讲得更具体:
它不是培养"会分析数据的人",而是培养"能把数据变成AI可用资产的人"。
这个定位,一下子把专业的独特价值说清楚了:
数据科学与大数据技术,研究的是"数据怎么被处理"——算法、框架、性能;
大数据管理与应用,研究的是"数据怎么被管好、用好、变成资产"——标准、质量、治理、资产化、场景化。
前者往算法深处走,后者往业务深处走。在AI时代,后者不是"低配版",而是"上游"——因为再好的模型,也要靠高质量数据集来喂。
具体到能力上,培养目标可以拆成五句话,每一句对应一种能力,而不是一门课:
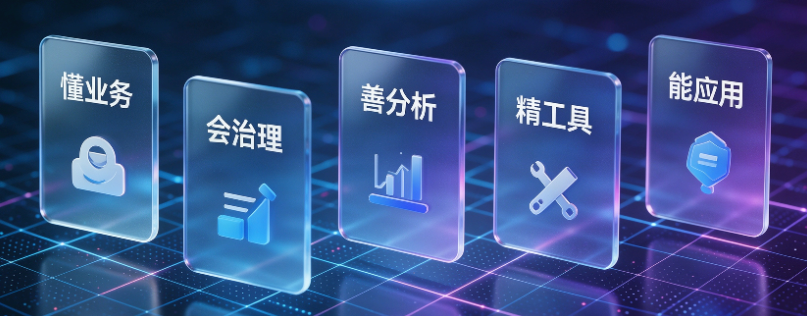
懂业务——理解行业流程与经营逻辑,能把模糊的管理诉求翻译成可分析、可建模的问题。
会治理——掌握数据作为生产要素的治理规则:标准、质量、元数据、血缘、安全、资产化。
善分析——具备统计思维与建模能力,能从数据里得到可解释、可行动的结论。
精工具——熟练使用SQL、Python、BI、数据治理平台、机器学习平台等产业侧主流工具链。
能应用——能把高质量数据集用于大模型微调与智能体开发,把数据结论与智能体能力落成可运行的管理改进或业务系统。
对应到岗位,是数据治理工程师、数据资产管理员、数据集运营专员、数据产品经理、商业数据分析师。它们的共同点很清楚:不要求你写出最强的算法,"把数据用到业务里、把数据管成资产、把大模型接进场景"。
美林数据深耕数据智能领域二十余年,服务制造、能源、金融、交通、环保等行业上千家头部企业的数字化转型;这些企业的用人标准,正是这五维能力模型最直接的来源。美林数据在产业侧提出的"一体两翼"AI工程化战略——AI工程化平台为主体,AI Ready数据工程与可信AI智能体为两翼——与数管专业的培养逻辑天然同构,能够把产业侧的能力要求直接翻译成教学内容。
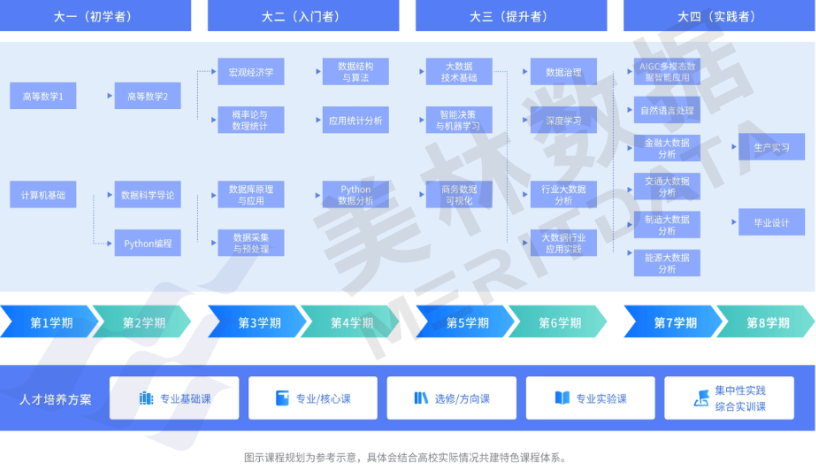
课程体系最容易犯的错,是按"开了哪些课"来组织。
数据课练清洗、开发课练框架、分析课练建模——每门课单独看都有用,学生却说不清这些技能在真实项目里解决的是同一个什么问题。
AI时代对课程体系提出了一个新要求:必须能把数据从"原始素材"一路送到"AI可用资产"。 这条链路有七个环节:规划 → 采集 → 治理 → 存储 → 分析 → 应用 → 服务。每个环节对应一组能力、一组课程、一组实验。学生沿着这条链走一遍,才算真正理解"数据是怎么变成资产的"。
落到课表上,有三处变化最关键:第一,数据治理从"选修"变成"核心"。 数据标准、数据质量、元数据管理、数据资产目录——这些过去被当作"进阶内容"的课,现在是构建高质量数据集的必备技能。已经有院校在2025级培养方案里,把"数据质量管理""数据标准制定""元数据管理"列为核心课程。
第二,新增"高质量数据集构建"。 大模型训练需要高质量的语料与样本,如何制定数据规范、管控数据质量、保障数据一致性,都是实打实的数据资产化工程能力。
第三,新增"数据资产化"与"数据合规"。 数据资产入表推进之后,企业对数据资产盘点、估值、运营、合规的要求,已经从"技术选项"变成了"合规刚需"。
课程体系沿“数据全生命周期”走了一遍,实验环境就必须能接得住这条链路。
传统院校的实验室在建设中受限于真实产业数据与全栈工具的缺乏,往往只能停留在传统的理论验证或单点操作层面。学生接触的多是理想化的教学样本,难以形成对真实业务闭环的认知。
在AI时代,一个合格的数管专业实验室,必须能把产业级的数据和工具链装进来,让学生在这里完整经历一次从“原始数据”到“高质量数据集”,再到“AI可用资产”的淬炼。
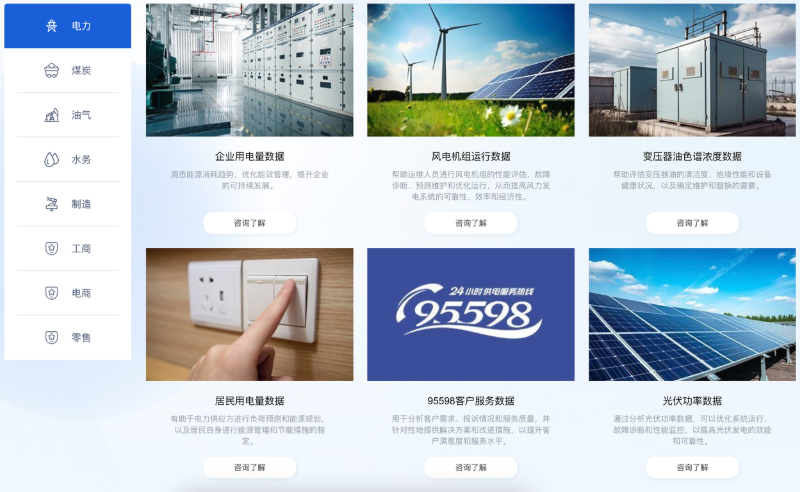
美林数据把产业侧项目沉淀的数据资产做脱敏与教学化处理,形成高质量数据集资源体系:覆盖金融、能源、制造、零售、政务等行业的真实产业数据,持续更新维护。这些数据集不是公开渠道的原始素材,而是按四个硬指标加工过的——来源经企业脱敏授权、格式与元数据体系统一、经清洗与质量校验、面向明确实训场景。学生练的,就是企业数据部门真正在用的东西。
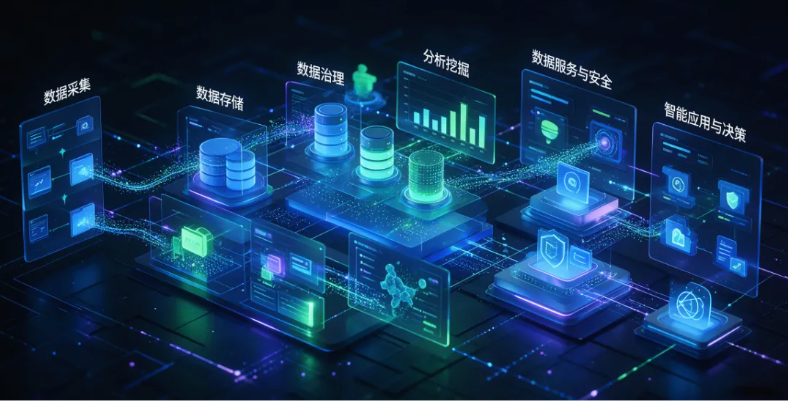
实训平台必须接入企业数字化转型的真实生产环境。这意味着,学生在平台上操作的不仅是分析软件,而是涵盖了数据采集、数据存储、数据治理、分析挖掘、数据服务与安全、智能应用与决策的全栈工具链。
从一份原始合同的解析,到一套设备工况的数据清洗,再到构建出一个可被大模型调用的数据集,学生在校就能体验数据要素在产业侧流转的全过程。这套环境已在政府、金融、制造等上万个头部单位深度应用,保证学生所学即所用。
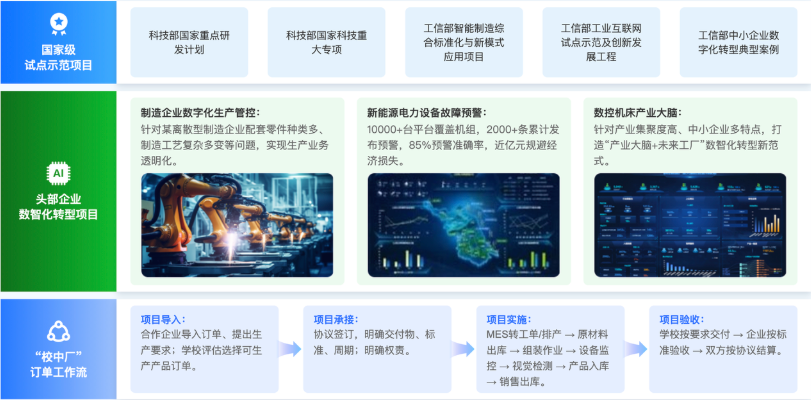
有了好数据、好工具,还需要真实的业务问题来练兵。
基于美林数据落地的3000+产业数字化转型项目案例,我们配套了千万级真实产业数据,打造了面向学生实战演练的课程资源。在这里,学生不再只是写一份“企业经营分析报告”,而是要模拟数据治理工程师、数据集运营专员、数据资产管理员等真实岗位,把模糊的业务诉求,转化为一份有数据字典、有质量报告、可直接用于模型微调的高质量数据集。
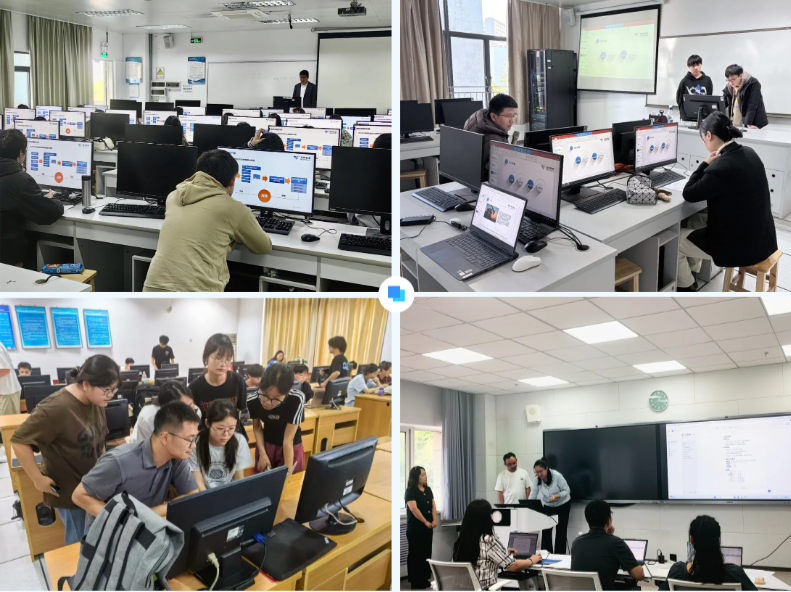
应用能力的终点,不止于技术过关,更在于职业素养的全面养成。
在真实的数据治理与数据集构建任务中,学生会经历真正的职场协作。平台强调将课程内容与实际职业需求紧密结合,通过情景构建与分组合作,让学生在解决复杂业务问题中,锻炼跨角色沟通与团队协作技巧。
同时,我们鼓励并组织学生参与国家级及行业级的数据竞赛、项目实践、认证考核与社会服务。在这个过程中,既磨炼了学生运用数字化工具解决现实问题的实战能力,又培养了创新思维与领导力,使学生在未来的职业生涯中具备真正的综合竞争力与创新潜力。
当学生开始处理海量真实数据时,教师如何掌握进度、如何评估质量?平台提供了伴随式的 AI 智能助教。
以“知识图谱+大模型”为引擎,教师可以自定义教学计划,查看学生实验进度与学习行为的全流程数据;考试中心提供题库与自动组卷;系统能追踪学生在“数据标准执行”、“质量规则校验”等关键环节的操作,做多维度学情分析。这不仅把教师从繁琐的批改中解放出来,更支撑了“教师主导—学生自主—智能辅助”的现代化教学场景。
过去,大数据专业的教学产出,终点往往是一张看板、一份分析报告。
学生做完一个项目,交上去的是一张"某企业经营分析大屏",评价标准是"图表对不对、结论有没有"。
但在高质量数据集这条线上,终点变了。
一份数据集做完,交上去的不该是报表,而是一份能被直接拿去训练、评测、上线的数据资产——它有明确的数据字典、标注规范、质量报告、版本记录,别人拿到它就能用。
评价标准也随之改变:不再是"查询结果对不对",而是"这份数据能不能把模型跑起来"。
这个变化,往上游推,改变了课程;往下游推,改变了出口:
往上,采集课要教"怎么按模型需求设计采集方案",治理课要教"什么质量水平才够训练用"、"如何通过元数据管理提升数据的可用性";
往下,数据集可以变成数据服务、数据产品、数据资产目录里的一个条目,也可以成为知识库的底座、模型微调的燃料。
这也是这个专业在AI时代最实在的价值:它不生产模型,但它生产模型赖以生存的东西。
回到开头那个问题:AI为什么用不起来?
因为数据没准备好。而数据没准备好,本质上是因为缺少既懂业务、又懂数据、还能把数据做成高质量数据集的人。
这正好是大数据管理与应用专业存在的理由。
只是这个理由,过去被讲成了"技管双强"这样一句正确但模糊的口号。在AI时代,它可以讲得更锋利一些:这个专业培养的,是AI时代的数据工程师——不造模型,但决定模型的上限。
如果你的院校正在规划或升级大数据管理与应用专业,正在思考如何把数据要素、高质量数据集融入专业建设,欢迎与美林数据联系。

 热门标签Popular tags

 全国服务电话
400-608-2558
029-8766-9737
 企业邮箱


 友情链接
 陕公网安备 61019002000171号

 立即试用


